

На протяжении многих десятилетий концепция искусственного интеллекта была прерогативой теоретических исследований по математике и научной фантастики. В 1950 году Алан Тьюринг в своей знаковой статье «Вычислительные машины и разум» задался фундаментальным вопросом: «Могут ли машины мыслить?». В то время, на заре рождающейся компьютерной эры, автоматизация ограничивалась жестко прописанными алгоритмами: машина безукоризненно выполняла инструкции типа «если X, то Y», но пасовала перед лицом неопределенности. Перелом произошел на рубеже XX и XXI веков, когда экспоненциальный рост вычислительных мощностей и появление колоссальных массивов данных (Big Data) позволили перейти от жесткого программирования к концепции машинного обучения (Machine Learning). Вместо закладывания готовых правил инженеры стали обучать системы находить скрытые закономерности самостоятельно. Однако долгое время эти прорывы оставались «лабораторными феномемами».
Модели, демонстрировавшие 99% точности на тестовых выборках в изолированных университетских средах, катастрофически разрушались при первой же попытке интегрировать их в реальное производство. Возникал фундаментальный разрыв между чисто научным экспериментом и предсказуемым, отказоустойчивым промышленным решением.
Сегодня этот разрыв преодолен. Переход машинного обучения из академической плоскости в индустриальную стал возможен благодаря появлению строгой методологии — MLOps (Machine Learning Operations), регламентирующей полный жизненный цикл и технологию разработки интеллектуальных систем. Жизнеспособная промышленная ML-модель — это больше не просто удачно обученный файл весов нейросети; это сложнейший инженерный конвейер (pipeline), работающий непрерывно и адаптирующийся к меняющейся реальности.
Внедрение таких систем коренным образом трансформировало ключевые отрасли мировой экономики:
- Тяжелая промышленность и металлургия: На заводах корпораций уровня Siemens или Северсталь ML-модели предиктивного обслуживания непрерывно анализируют вибрацию, температуру и акустические шумы прокатных станов. Предсказывая износ подшипника за две недели до его фактической поломки, система спасает предприятие от многомиллионных убытков, вызванных экстренной остановкой конвейера.
- Финтех и банковский сектор: Современный антифрод-мониторинг (например, в системах Visa или крупнейших транснациональных банков) оценивает риски каждой транзакции менее чем за 100 миллисекунд. Модель анализирует геолокацию пользователя, паттерны его типичного поведения, сумму и специфику торговой точки, мгновенно блокируя мошеннические операции в масштабах сотен тысяч запросов в секунду.
- Автономный транспорт: В беспилотных автомобилях (Waymo, Tesla) модели компьютерного зрения и слияния данных с сенсоров работают в условиях жесткого реального времени. Ошибка или задержка в адаптации модели к изменившимся погодным условиям недопустима, поскольку цена сбоя здесь — человеческая жизнь.
Создание интеллектуального продукта, способного выдерживать подобные нагрузки, требует жесткой дисциплины, глубокого понимания архитектуры данных и системного подхода к каждому этапу разработки. В данной статье мы подробно разберем, из каких фаз состоит жизненный цикл промышленной ML-модели — от формулирования бизнес-гипотезы до непрерывного мониторинга в продакшене — и какие технологические стек-решения обеспечивают ее выживание в агрессивной среде реального бизнеса.
Как правило, в процессе выполнения больших проектов в области машинного обучения участвует достаточно много специалистов, которые составляют проектную команду, вовлеченную в обработку данных. Очевидно, что здесь существуют проблемы, связанные с управлением проектом, поскольку требуется проведение разработки модели машинного обучения (Machine Learning model), а также ее тестирования. Каким же образом наиболее эффективно синхронизировать код и результаты экспериментов? После разработки и оптимизации ML-модели возникает необходимость ее развертывания в промышленной среде. Все эти проблемы могут казаться менее увлекательными, чем решение самой задачи машинного обучения, но они имеют критическое значение для успешной реализации ML-проектов. В этой статье мы подробно рассмотрим жизненный цикл ML-сервиса от идеи до разработки и внедрения, а также инструменты и принципы, используемые на каждом этапе.
План статьи
- Жизненный цикл и участники ML-проекта
- Оценка, анализ и подготовка данных
- Автоматизация процесса разработки и тестирования ML-моделей
- Схемы развертывания ML-моделей в промышленную эксплуатацию
Жизненный цикл и участники ML-проекта
Проекты искусственного интеллекта могут казаться новым миром, но на практике они следуют стандартным этапам IT-проекта. На этапах, связанных с машинным обучением, необходимо использовать специализированные инструменты, которые на сегодняшний день являются достаточно продвинутыми. На схеме представлены основные этапы IT-проекта, зеленым выделена ML-специфика:
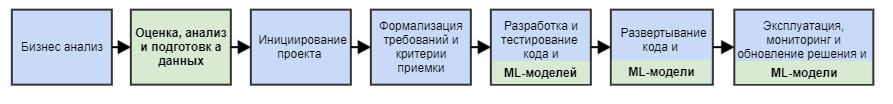
- Этап бизнес анализа является стандартным для всех IT и не IT-проектов.
На этом этапе происходит постановка бизнес целей.
- Оценка объема и качества имеющихся данных. Анализ и формирование требований к данным.
Это ключевая специфика ML-проектов. Результаты этого этапа влияют на жизнеспособность всего проекта, поэтому он стоит в начале проекта, к нему сразу привлекаются специалисты по анализу данных и выделяется специальное время на изучение данных.
- Инициирование проекта, с принятием решения Go / No-Go также стандартный этап в проектном управлении.
- Формализация требований и критериев приемки работы. На этом этапе происходит:
- Выработка и согласование с заказчиком функциональных и нефункциональных требований в виде документов: ТЗ, ПМИ, требования по производительность и т.д.
- Определение бюджета и необходимого оборудования.
- Этап разработки и тестирования ML-моделей и кода является самым объемным по ресурсам и времени.
- Если результаты предыдущих этапов выполняют поставленные бизнес требования, то принимается решение о промышленном развертывании решения.
- Далее следует эксплуатация, мониторинг и обновление решения и ML-модели.
На разных этапах проекта привлекаются специалисты по машинному обучению с разными ролями. В рамках ML-проектов выделяют несколько ключевых ролей, которые могут выполняться как разными, таки и одними и теми же людьми или иметь пересекающиеся обязанности:
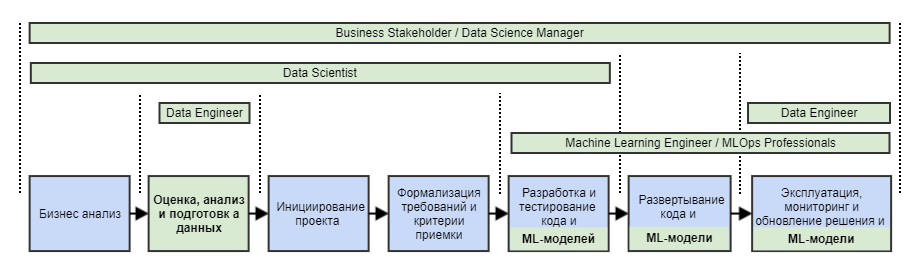
- Business Stakeholder / Data Science Managers – наблюдают за процессом в целом и контролируют всю деятельность.
- Machine Learning Engineer / MLOps Professionals
- Обеспечивают техническую реализацию обучения моделей.
- Развертывают их в промышленную эксплуатацию с помощью средств CI / CD.
- Мониторят и переобучают ML-модели на новых данных.
- Data Scientists занимаются анализом данных и построением моделей с научной точки зрения. Такие сотрудники называются по-разному в зависимости от области, в которой работают:
- Deep Learning Engineer – инженер глубокого обучения.
- Computer Vision Researcher – исследователь компьютерного зрения.
- NLP Scientist – ученый по обработке естественного языка.
- Data Engineers занимаются сбором и подготовкой данных с технической точки зрения:
- Разрабатывают инфраструктуру работы с данными.
- Контролируют и поддерживают потоки данных и работоспособность систем, настраивают системы мониторинга.
Далее подробно рассмотрим ключевые этапы ML-проекта.
Оценка, анализ и подготовка данных
В общем виде анализ и подготовка данных состоит из следующих этапов:
Получение данных (Ingestion)
- Получение и обогащение данных из разных источников.
- Анонимизация данных – очистка от персональных и чувствительных для бизнеса данных.
- Разделение данных (Data Splitting) на данные для обучения, проверки и тестирования.
Хорошая практика на данном этапе – всегда сохранять исходные данные без изменений, а эксперименты проводить с копиями данных.
Исследование и проверка (Exploration and Validation)
- Исследование структуры данных – min, max, среднее, статистическое распределение.
- Проверка данных на корректность типов и форматов.
- Визуализация данных.
- Определение зависимостей между атрибутами (attribute correlation).
На этом этапе необходимо определить нужны ли какие-нибудь дополнительные данные или можно двигаться дальше.
Очистка данных (Data Cleaning)
- Трансформация данных.
- Заполнение пропусков.
- Удаление выбросов в данных.
- Удаление данных, которые не имеют отношения к решаемой задаче.
После подготовки данных начинается этап разработки кода и ML-модели.
Разработка и тестирование ML-моделей
Разработка ML-моделей
Разработка ML-моделей обычно состоит из следующих шагов:
Model Training
- Feature Engineering, уменьшение размерности, нормализация данных;
- Подбор гиперпараметров модели.
Model Engineering
- Выбор подходящей ML-модели или комбинации моделей;
- Разработка, ревью, версионирование кода ML-модели;
- Оценка качества и выбор лучшей модели;
- Оптимизация гиперпараметров модели.
Model Evaluation & Testing
- Проверка модели, что она выполняет бизнес задачу;
- Тестирование на проверочных данных.
Model Packaging
- Сохранение в стандартном формате для дальнейшего использования.
Автоматизация процесса разработки и тестирования ML-моделей (MLOps)
Для выполнения задач в рамках ML проектов необходимо использовать специализированные инструменты. Использование таких средств позволяет обеспечить воспроизводимость результатов на всех этапах жизненного цикла ML-модели:
- Repeatability – воспроизводимость экспериментов во время разработки
- Reproducibility – прозрачный перенос ML-модели на промышленную площадку
- Replicability – тиражирование общего решения
Для автоматизации анализа данных используются средства для построения конвейеров (pipelines), которые позволяют версионировать данные и модели, автоматически выполнять необходимые шаги. Примером такой системы является Data Version Control (DVC), которую называют Git для данных.
Для автоматизации разработки и развертывания ML-моделей появилось понятие MLOps. Средства MLOps используется для сохранения результатов ML-экспериментов, версий моделей, для тестирования и развертывания моделей. Сейчас существует несколько средств, реализующих основную функциональность MLOps:
- MLflow
- Neptune AI
- Kubeflow – для развертывания в Kubernetes
- Weights & Biases (W&B)
- ClearML
Платформа MLflow
Рассмотрим подробнее платформу MLflow. Она состоит из следующих основных компонент, предназначенных для работы с ML-проектами:
- MLflow Tracking – отслеживает и логирует процесс обучения модели. Сохраняет результаты экспериментов, конфигурационные данные и гиперпараметры модели. Позволяет визуализировать метрики, сравнивать результаты и выбирать наилучший вариант модели.
- MLflow Projects – модуль предназначен для сохранения данных, кода и всех зависимостей для возможности повторить эксперименты на разных платформах.
- MLflow Models – позволяет сохранять ML-модели в стандартных форматах для дальнейшего разворота в различных окружениях. Наиболее распространенные форматы:
- MLflow Registry – хранит и управляет версиями ML-моделей в центральном хранилище.
- MLflow deployment toolset – позволяет разворачивать модели на облачных и локальных платформах.
Схемы развертывания MLflow
Существуют различные схемы для развертывания и использования MLflow. Приведу наиболее общую схему с выделенным сервером MLflow Server:
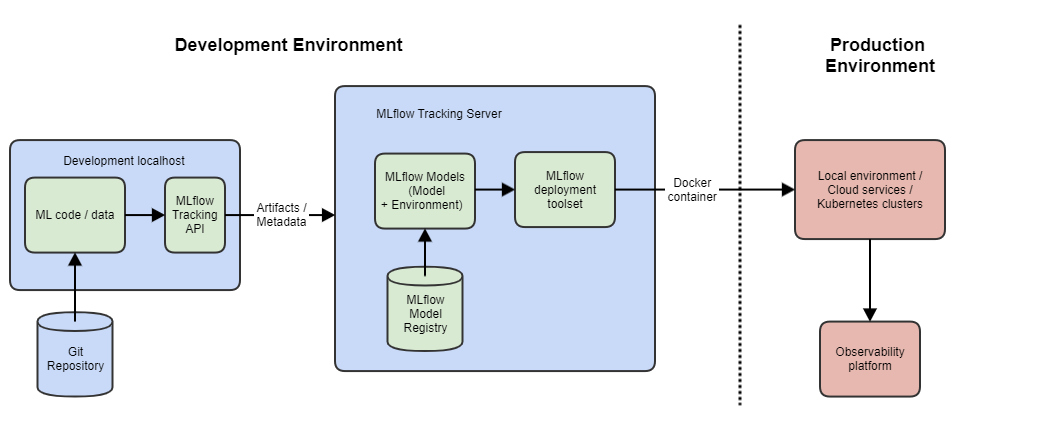
При такой схеме процесс разработки и деплоя ML-модели выглядит следующим образом:
- ML-модель разрабатывается и тестируется на локальном оборудовании, которое интегрировано с сервером MLflow Tracking.
- Исходные коды и данные для построения ML-модели хранятся в Git-е.
- Реализованные ML-модели сохраняются в MLflow Registry.
- MLflow Models переносит модель в виртуальное окружение (virtual environment) для локального развертывания или docker контейнер для развертывания в облачных платформах и Kubernetes.
- С помощью MLflow Deployment toolset осуществляется развертывание модели в промышленную среду.
Мониторинг работы ML-модели осуществляется с помощью специальных платформ, например, Evidently.
Развертывание ML-моделей
Схемы развертывания в зависимости от типа обучения и предсказания
Различают следующие типы обучения и предсказания:
- ML-model Training:
- Offline Training – модели тренируются на уже собранных (исторических) данных, при работе модель остается валидной какое-то время, но потом необходим процесс переобучения на актуальных данных.
- Online Training – постоянное переобучение модели на вновь поступающих данных.
- ML-model Prediction:
- Offline (batch prediction) – в этом случае для предсказания используются заранее сгенерированные данные.
- Real-time prediction (On-demand predictions) – для предсказания используются вновь поступающие данные из запроса.
Используя эти типы можно построить следующую матрицу:
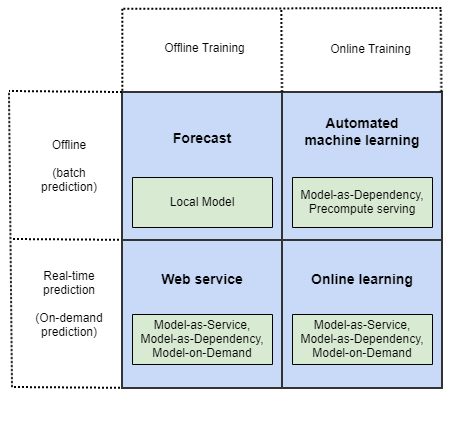
В ее клетках помещены названия схем, реализующих требуемую функциональность:
- Forecast
- Automated machine learning
- Web service
- Online learning
Также в клетках приведены шаблоны встраивания ML-моделей в промышленные системы, с помощью которых возможно реализовать перечисленные схемы:
- Model-as-Service
- Model-as-Dependency
- Model-on-Demand
- Precompute serving
Далее кратко опишу схемы и шаблоны:
Forecast – для построения модели обычно используются статические данные в виде файлов. Предсказание также осуществляется на статических данных. В таком режиме работают BI системы и научные исследования данных. Схема не предназначена для работы в промышленных системах.
Web service – наиболее популярная схема использования. В ней ML-модель строится на исторических данных, но информация для предсказания берется из запроса в реальном времени. Переобучение модели на актуальных данных можно запускать периодически или же сам запрос может запускать процесс обучения на актуальных данных (batch run).
Online learning – наиболее динамичная схема. Обычно используется на потоковых данных, когда модель должна постоянно изменяться. Переобучение может происходить не на промышленной системе, а параллельно и тогда для этой схемы больше подходит наименование “инкрементальное обучение”. В таких системах есть риски, что пришедшие некачественные данные ухудшат качество модели.
Automated machine learning – в этой схеме происходит автоматическое обучение, оптимизация результатов и выбор ML-модели. Реализация таких систем зачастую более сложная задача, чем online learning, т.к.требует от пользователя только предоставление данных, а ML-модель автоматически подбирается самой системой. Обычно реализуется крупными провайдерами ИИ, такими как Google или Microsoft.
Шаблоны встраивания ML-моделей (Model Serving Patterns)
Каждая схема предсказания и обучения может быть реализована разными техническими шаблонами:
Model-as-Service – наиболее простой шаблон. ML-модель работает как сервис, к которому приложение делает запросы с помощью REST API:
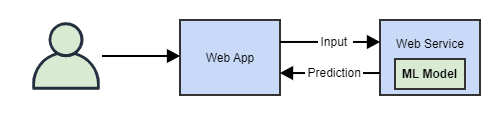
Model-as-Dependency – наиболее прямолинейный способ использования ML-модели. При реализации этого шаблона модель встраивается в приложение:

Precompute serving – при реализации шаблона используются заранее подготовленные предсказания:
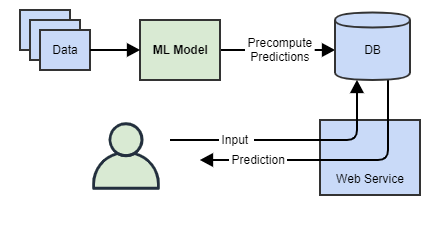
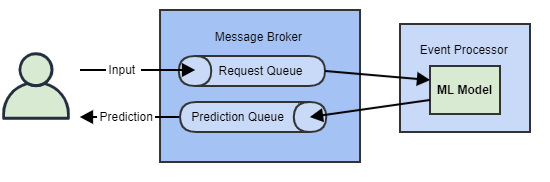
Model-on-Demand – шаблон похож на Model-as-Dependency, в котором используется архитектура message broker с двумя компонентами:
- Message Broker с двумя очередями;
- Event processor, который обслуживает запросы.
Заключение
В статье мы рассмотрели этапы реализации проектов машинного обучения и отметили важность всех этапов для достижения успеха. Выяснили, что мир искусственного интеллекта состоит не только из ученых Data Sciences, но и из ML-инженеров, которые воплощают идеи в жизнь. Были подробно рассмотрены этапы анализа и подготовки данных, разработки и тестирования ML-моделей, а также схемы развертывания в промышленной среде.
Без грамотной технической реализации и организации процесса прекрасная идея так и останется лишь абстракцией!
Создание жизнеспособной промышленной модели на основе машинного обучения — это не разовый акт написания программного кода, а непрерывный инженерный процесс, требующий жесткой дисциплины и синергии множества дисциплин. Опыт последних лет наглядно доказал: ценность интеллектуальной системы определяется не столько сложностью ее математической архитектуры, сколько надежностью инфраструктуры, развернутой вокруг нее. Успешный переход от лабораторного эксперимента к масштабному производству (Production) невозможен без внедрения практик MLOps, которые превращают хрупкие аналитические скрипты в предсказуемые, контролируемые и отказоустойчивые программные продукты. Безопасность, интерпретируемость результатов, воспроизводимость экспериментов и автоматизация пайплайнов данных сегодня составляют фундамент, на котором строится цифровая трансформация ключевых отраслей мировой экономики.
Перспективы развития технологии
Ландшафт промышленного машинного обучения стремительно эволюционирует, смещая фокус с рутинного администрирования на сквозную автоматизацию и повышение интеллектуальности самих процессов разработки. В ближайшие годы ключевыми векторами развития технологии станут:
- Интеграция больших языковых моделей и генеративного ИИ в производство (LLMOps): Управление жизненным циклом классических моделей дополняется инструментами для развертывания мультимодальных систем и LLM. Это требует кардинально новых подходов к оптимизации вычислительных ресурсов (квантование, дистилляция), защите от «галлюцинаций» и оркестровке сложных агентных систем.
- Концепция Data-Centric AI (ИИ, ориентированный на данные): Вместо бесконечного усложнения архитектур нейросетей индустрия переходит к автоматизированному повышению качества самих данных. Системы программной разметки (Weak Supervision), генерация синтетических данных для обучения и автоматический поиск аномалий в датасетах становятся стандартными этапами конвейера.
- Edge AI и федеративное обучение (Federated Learning): Перенос вычислений непосредственно на конечные устройства (смартфоны, датчики интернета вещей, бортовые компьютеры автомобилей) позволяет снизить задержки и повысить конфиденциальность. Федеративное обучение дает возможность обучать глобальные модели на распределенных данных без необходимости их сбора в едином централизованном хранилище.
- Зеленый ИИ (Green AI) и энергоэффективность: С ростом масштабов нейросетей критически важным фактором становится углеродный след и энергопотребление дата-центров. Разработка аппаратных ускорителей нового поколения и алгоритмов эффективного сжатия моделей станет приоритетом для снижения операционных издержек.
Часто задаваемые вопросы (FAQ)
- В чем главное отличие промышленной ML-модели от академической (лабораторной)?
Академическая модель создается для проверки гипотезы на статичном, заранее очищенном наборе данных, а ее главной метрикой является точность (например, F1-score). Промышленная модель работает с непрерывным потоком «грязных» реальных данных, интегрирована в существующую ИТ-инфраструктуру предприятия и оценивается по бизнес-метрикам (ROI, скорость ответа, отказоустойчивость, стоимость поддержки). - Что такое «деградация модели» (Model Drift) и как с ней бороться?
Деградация — это постепенное снижение точности работы модели в продакшене из-за изменения характеристик входящих данных (Data Drift) или изменения самой сути предсказываемого явления (Concept Drift). Для борьбы с этим эффектом внедряют системы непрерывного мониторинга метрик, автоматическое оповещение об аномалиях и пайплайны регулярного дообучения (Retraining) модели на свежих данных. - Какова роль методологии MLOps в жизненном цикле разработки?
MLOps (Machine Learning Operations) — это набор практик, объединяющий дата-сайентистов, ML-инженеров и IT-экспертов по эксплуатации. MLOps автоматизирует процессы тестирования, развертывания, версионирования (данных, кода и моделей) и мониторинга, сокращая время вывода продукта на рынок (Time-to-Market) и обеспечивая стабильность системы при изменениях внешней среды. - Стоит ли инвестировать в создание собственной инфраструктуры машинного обучения или лучше использовать готовые облачные платформы (Cloud AI)?
Выбор зависит от масштаба бизнеса, регуляторных требований и бюджета. Облачные платформы (PaaS/SaaS) позволяют быстро запуститься и снизить стартовые затраты, что идеально для стартапов и пилотных проектов. Собственная инфраструктура (On-Premise) требует значительных капитальных вложений и штата инженеров, однако необходима крупным корпорациям из секторов финтеха, медицины или тяжелой промышленности из соображений безопасности данных (коммерческая тайна, персональные данные) и долгосрочной экономии на масштабе.
Несколько ссылок для углубленного изучения
- Статья от сообщества MLOps (Machine Learning Model Operationalization Management) про данные, ML-модели и код приложения: Three Levels of ML Software;
- Лекция в Nexign Анны Авдюшиной, аспиранта и инженер-программиста ИТМО и МФТИ “Как внедрить модели машинного обучения в продакшен”;
- Курсы от сообщества ODS (Open Data Science)
- Методы и инструменты MLOps: “MLOps и production подход к ML исследованиям 2.0”;
- А этот курс только начинается (март 2024), еще можно принять участие вживую: “MLOps и production в DS исследованиях 3.0”;
- Курс по дизайну систем машинного обучения: “ML System Design”.
Автор: Алексей Сушков @AlexeySushkov
Источник: https://habr.com/


