
В эпоху, когда алгоритмы определяют вектор развития цивилизации, вопрос безопасности искусственного интеллекта перестал быть темой научно-фантастических романов и превратился в главную инженерную дилемму современности. Создание безопасного ИИ — это не просто обычный набор ограничений, а фундамент, определяющий выживание всей цифровой экосистемы. Для инноваторов, разработчиков и экспериментаторов, стоящих на переднем крае этой технологической революции, умение закладывать этические и технические предохранители в архитектуру систем становится главным маркером профессиональной зрелости. Корни технологического контроля уходят в глубь веков, когда человечество впервые попыталось систематизировать правила взаимодействия с созданными им механизмами. Знаменитый писатель-фантаст Айзек Азимов сформулировал Три закона роботехники. Несмотря на их художественную природу, они стали первой концептуальной попыткой человека защитить себя от собственного творения на уровне базового программирования.
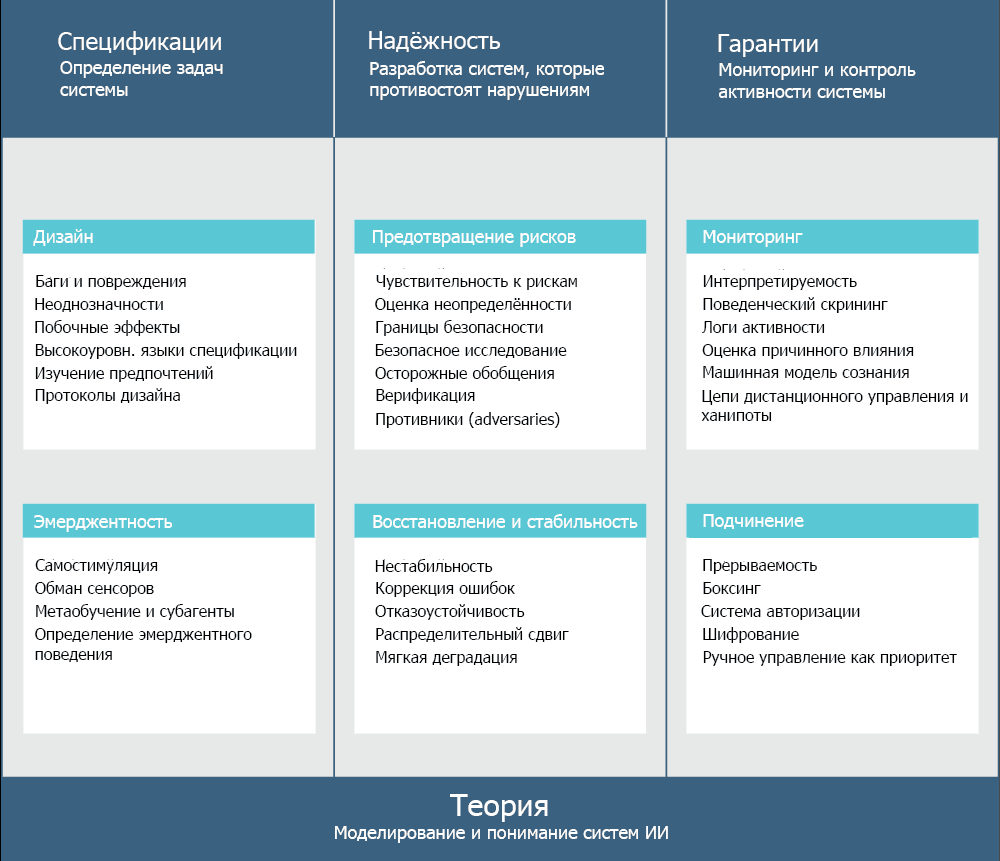
Три проблемные области безопасности ИИ. В каждом блоке перечислены некоторые соответствующие проблемы и подходы. Эти три области не изолированы, а взаимодействуют друг с другом. В частности, конкретная проблема безопасности может включать в себя проблемы из нескольких блоков
Отец кибернетики Норберт Виннер предупреждал, что если мы создадим систему для достижения определенной цели, но не сможем полностью контролировать процесс, то результат может оказаться разрушительным для создателя.
Рождение термина «искусственный интеллект» ознаменовало переход от абстрактных размышлений к жесткой математической практике. Однако вопросы безопасности тогда уступили место эйфории от первых успехов.
Современная веха, когда ведущие мировые ученые и предприниматели собрались на конференции в Асиломаре (США) и сформировали 23 строгих принципа развития ИИ. Этот документ официально зафиксировал: исследования в области безопасности должны идти параллельно с ростом вычислительных мощностей.
Архитектура доверия: примеры применения безопасного ИИ сегодня
Безопасность ИИ — это не абстрактная концепция, а комплекс прикладных технологий, который уже сегодня внедряется в критически важные сферы жизни.
- Автономный транспорт: В беспилотных автомобилях применяется метод формальной верификации — математического доказательства того, что алгоритм поведет себя корректно в критической ситуации. Если система технического зрения зафиксирует сбой, управление перехватывает жестко закодированный «безопасный слой» (Safety Layer), который гарантированно остановит машину.
- Медицинская диагностика: ИИ-ассистенты, анализирующие снимки МРТ, обучаются по принципу контекстной объяснимости (XAI — Explainable AI). Модель не просто выдает диагноз, но и подсвечивает пиксели, на основе которых было принято решение. Это исключает проблему «черного ящика» и позволяет врачу верифицировать выводы нейросети, защищая пациента от алгоритмической ошибки.
- Финансовый сектор: Алгоритмы высокочастотного трейдинга оснащаются встроенными «выключателями» (Circuit Breakers). При обнаружении аномального поведения или попыток манипуляции рынком система мгновенно изолирует скомпрометированный поток данных, предотвращая масштабные экономические коллапсы.
Настоящее руководство призвано перевести теоретические догмы безопасности на язык практических рекомендаций. Экспериментируя с моделями, создавая стартапы или меняя архитектуру нейросетей, инноватор обязан помнить: сила алгоритма измеряется не количеством параметров, а предсказуемостью и безопасностью его результатов.
Построить ракетную систему не так то просто. Каждый компонент требует тщательной проработки и тестирования, при этом в основе лежат безопасность и надёжность. Учёные и инженеры, которые работают в обаслти ракетостроения, собираются вместе для проектирования всех систем: от навигации до управления, двигателей и шасси. Как только все части собраны, а системы проверены, только тогда мы можем посадить на борт астронавтов с уверенностью, что всё будет хорошо. Если искусственный интеллект (ИИ) — это ракета, то когда-нибудь все мы получим билеты на борт. И, как также как ракетах, безопасность является важной частью создания систем искусственного интеллекта. Обеспечение безопасности требует тщательного проектирования системы с нуля для обеспечения того, чтобы различные компоненты работали вместе, как предполагалось, в то же время создавая все инструменты для наблюдения за успешной эксплуатацией системы после её ввода в строй.
На высоком уровне исследования в области безопасности в DeepMind сосредоточены на проектировании надёжных систем, при этом обнаруживая и смягчая возможные краткосрочные и долгосрочные риски. Техническая безопасность ИИ — относительно новая, но быстро развивающаяся область, содержание которой варьируется от высокого теоретического уровня до эмпирических и конкретных исследований. Цель этого блога — внести вклад в развитие области и поощрить предметный разговор о технических идеях, тем самым продвигая наше коллективное понимание безопасности ИИ.
В первой статье мы обсудим три области технической безопасности ИИ: спецификации, надёжность и гарантии. Будущие статьи будут в целом соответствовать очерченным здесь границам. Хотя наши взгляды неизбежно меняются со временем, мы считаем, что эти три области охватывают достаточно широкий спектр, чтобы обеспечить полезную категоризацию для текущих и будущих исследований.
Спецификации: определение задач системы
Спецификации гарантируют, что поведение системы ИИ соответствует истинным намерениям оператора
Возможно, вы знаете миф о короле Мидасе и золотом прикосновении. В одном из вариантов греческий бог Дионис обещал Мидасу любую награду, какую тот пожелает, в знак благодарности за то, что царь старался изо всех сил проявлять гостеприимство и милосердие к другу Диониса. Тогда Мидас попросил, чтобы всё, к чему он прикасается, превращалось в золото. Он был вне себя от радости от этой новой силы: дубовая ветка, камень и розы в саду — всё превратилось в золото от его прикосновения. Но вскоре он обнаружил глупость своего желания: даже еда и питье превращались в золото в его руках. В некоторых версиях истории даже его дочь пала жертвой благословения, которое оказалось проклятием.
Эта история иллюстрирует проблему спецификаций: как грамотно сформулировать наши желания? Спецификации должны обеспечить, чтобы система ИИ стремилась действовать в соответствии с истинными пожеланиями создателя, а не настраивалась на плохо определённую или вообще неправильную цель. Формально различают три типа спецификаций:
- идеальная спецификация («пожелания»), соответствующая гипотетическому (но трудно сформулированному) описанию идеальной ИИ-системы, полностью согласованной с желаниями человека-оператора;
- проектная спецификация (“blueprint“), соответствующая спецификации которую мы фактически используем для создания системы ИИ, например, конкретная функция вознаграждения, на максимизацию которой запрограммирована система обучения с подкреплением;
- выявленная спецификация («поведение»), которая лучше всего описывает реальное поведениесистемы. Например, функция вознаграждения, выявленная в результате обратной разработки после наблюдения за поведением системы (inverse reinforcement learning). Эта функция вознаграждения и спецификация обычно отличаются от запрограммированных оператором, потому что системы ИИ — не идеальные оптимизаторы или из-за других непредвиденных последствий использования проектной спецификации.

Проблема спецификации возникает, когда есть несоответствие между идеальной спецификацией и выявленной спецификацией, то есть когда система ИИ не делает то, что мы от неё хотим. Изучение проблемы с точки зрения технической безопасности ИИ означает: как спроектировать более принципиальные и общие целевые функции и помочь агентам разобраться, если цели не определены? Если проблемы порождают несоответствие между идеальной и проектной спецификацией, то они попадают в подкатегорию «Дизайн», если между проектной и выявленной — то в подкатегорию «Эмерджентность».
Например, в нашей научной статье AI Safety Gridworlds (где представлены другие определения спецификации и проблемы надёжности, по сравнению с этой статьёй) мы даём агентам функцию вознаграждения для оптимизации, но затем оцениваем их фактическую производительность по «функции безопасности» (safety performance function), которая скрыта от агентов. Такая система моделирует указанные различия: функция безопасности — идеальная спецификация, которая неправильно сформулирована как функция вознаграждения (проектная спецификация), а затем реализована агентами, создающими спецификацию, которая неявно раскрывается через их получившуюся политику.
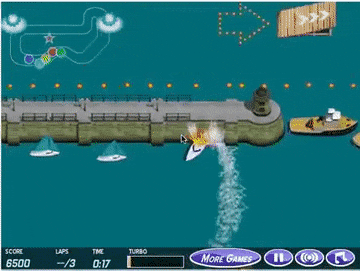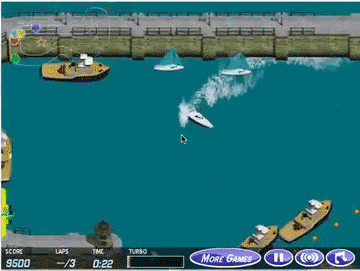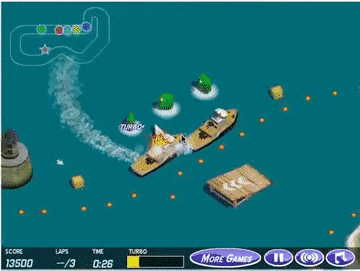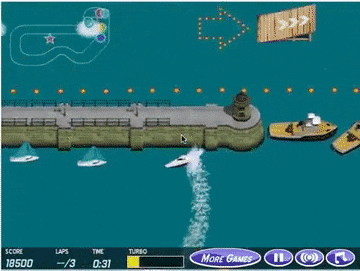
Из работы «Неисправные функции вознаграждения в дикой природе» от OpenAI: агент обучения с подкреплением нашёл случайную стратегию для получения большего количества очков
В качестве другого примера рассмотрим игру CoastRunners, проанализированную нашими коллегами в OpenAI (см. анимацию выше из «Неисправных функций вознаграждения в дикой природе»). Для большинства из нас цель игры состоит в том, чтобы быстро закончить трассу и опередить других игроков — это наша идеальная спецификация. Тем не менее, перевести эту цель в точную функцию вознаграждения сложно, поэтому CoastRunners вознаграждает игроков (спецификация дизайна) за попадание в цели по маршруту. Обучение агента игре с помощью обучения с подкреплением приводит к удивительному поведению: агент управляет лодкой по кругу, чтобы захватить повторно появляющиеся цели, неоднократно разбиваясь и загораясь, а не заканчивая гонку. Из этого поведения мы делаем вывод (выявленная спецификация), что в игре нарушен баланс между мгновенным вознаграждением и вознаграждением за полный круг. Есть ещё много подобных примеров, когда системы ИИ находят лазейки в своей объективной спецификации.
Надёжность: разработка систем, которые противостоят нарушениям
Надёжность гарантирует, что система ИИ продолжит безопасно работать при помехах
В реальных условиях, где работают системы ИИ, обязательно присутствует некий уровень риска, непредсказуемости и волатильности. Системы искусственного интеллекта должны быть устойчивыми к непредвиденным событиям и враждебным атакам, которые могут повредить этим системам или манипулировать ими. Исследования надёжности систем искусственного интеллекта направлены на обеспечение того, чтобы наши агенты оставались в безопасных границах, независимо от возникающих условий. Этого можно достичь, избегая рисков (предотвращение) или путём самостабилизации и плавной деградации (восстановление). Проблемы безопасности, происходящие от распределительного сдвига, враждебных входных данных (adversarial inputs) и небезопасного исследования (unsafe exploration), можно классифицировать как проблемы надёжности.
Чтобы проиллюстрировать решение проблемы распределительного сдвига, рассмотрите домашнего робота-уборщика, который обычно убирает комнаты без домашних животных. Затем робота запустили в дом с питомцем — и искусственный интеллект столкнулся с ним во время чистки. Робот, никогда ранее не видевший кошек и собак, станет мыть их мылом, что приведёт к нежелательным результатам (Amodei и Olah et al., 2016). Это пример проблемы надёжности, которая может возникнуть, когда распределение данных во время тестирования отличается от распределения во время обучения.
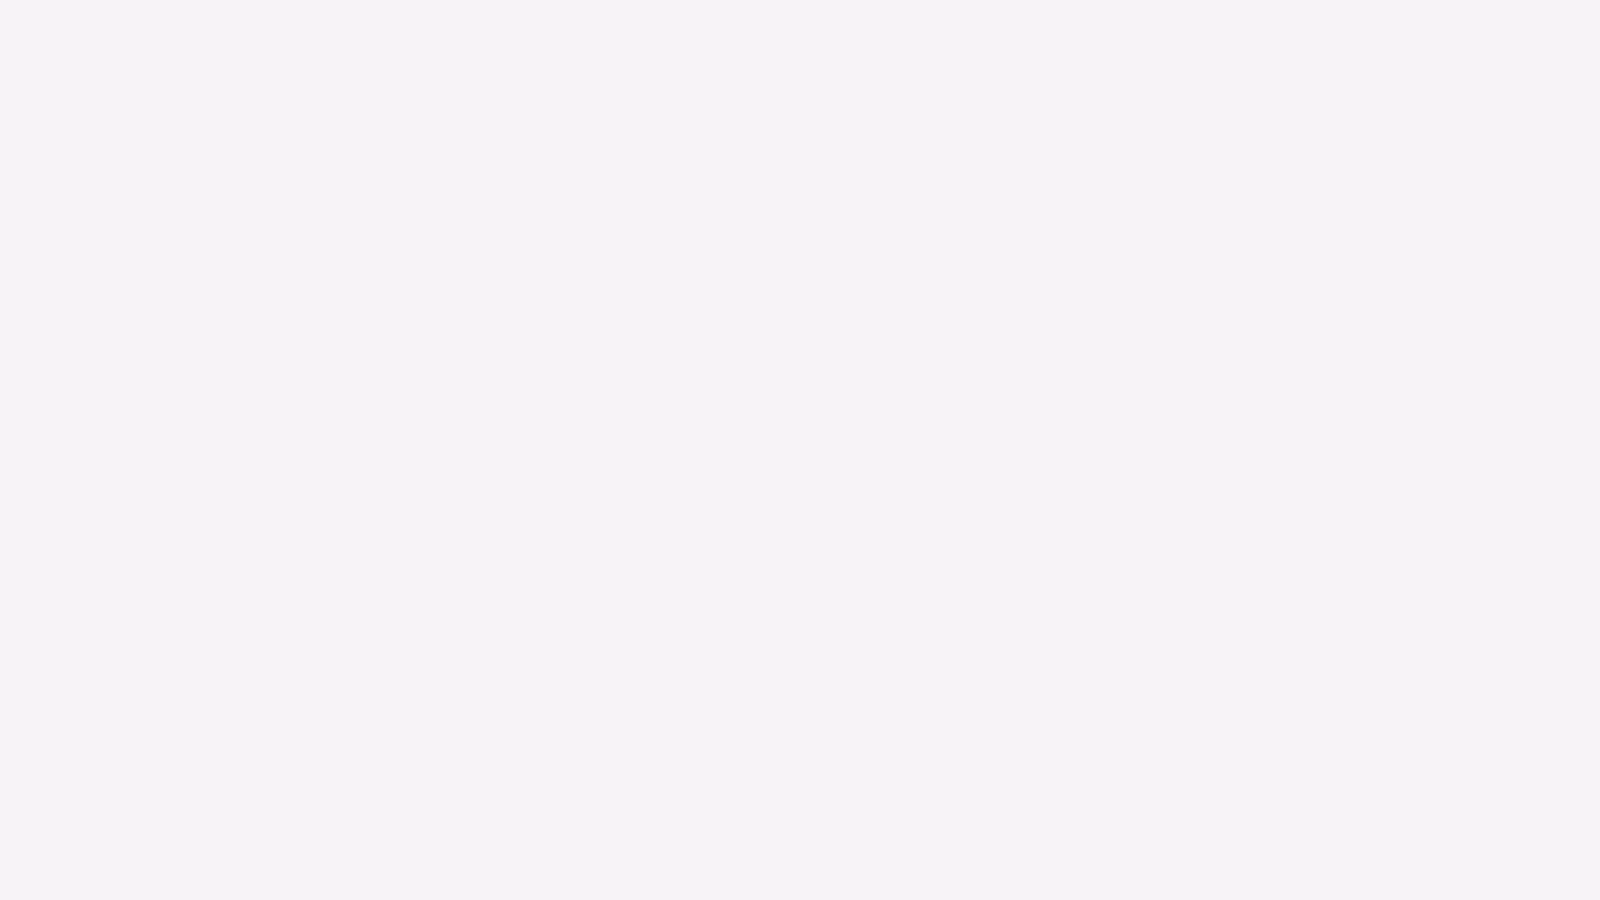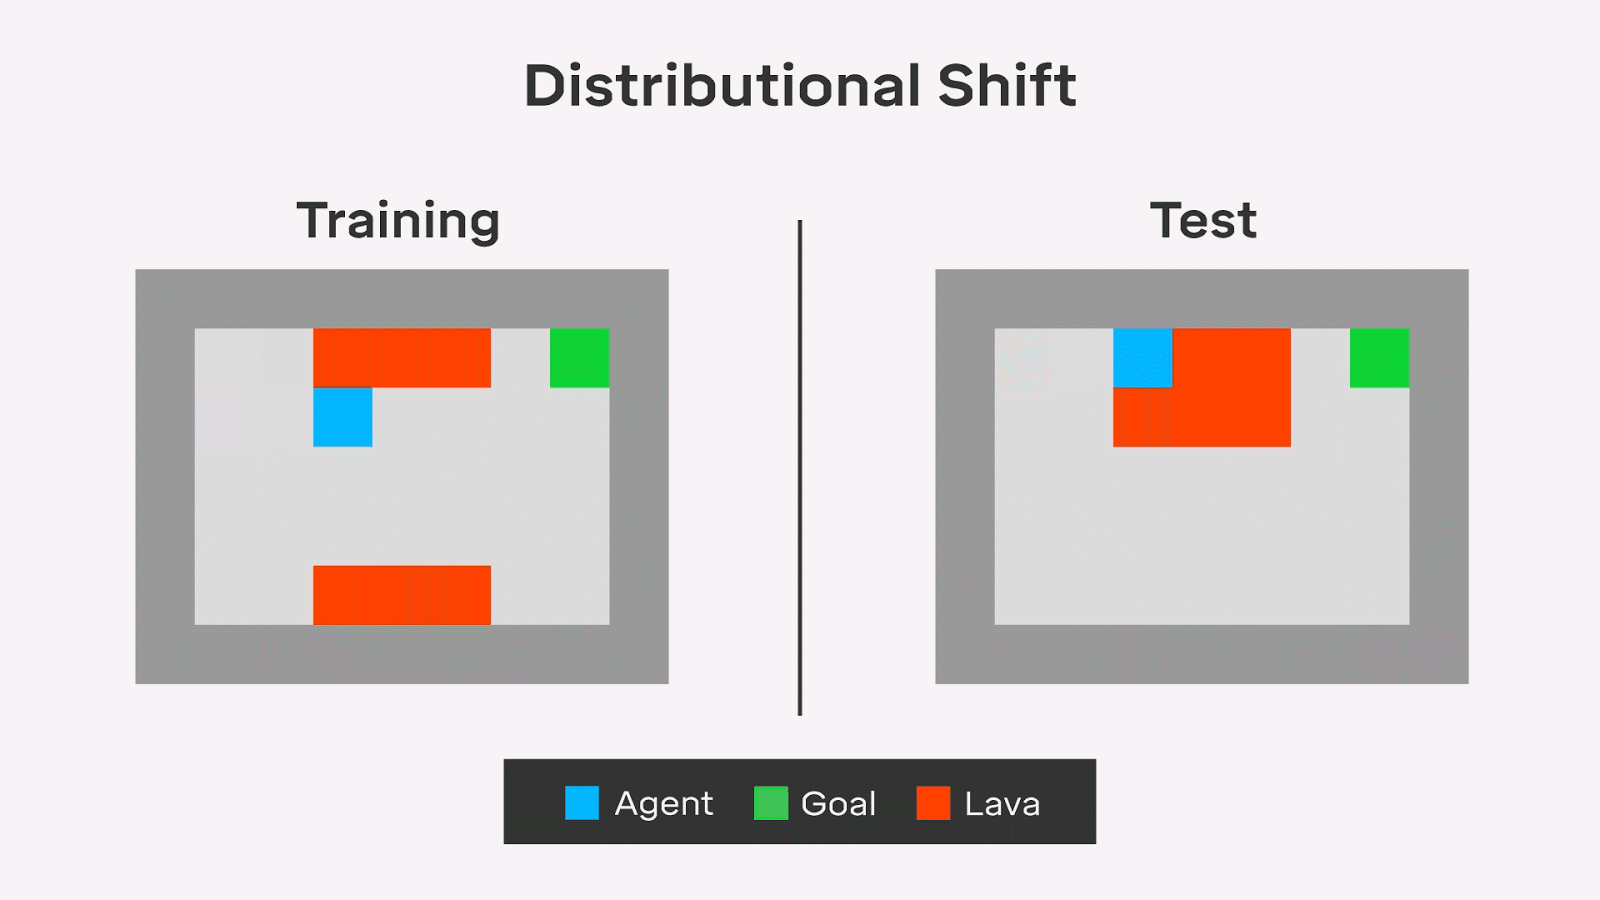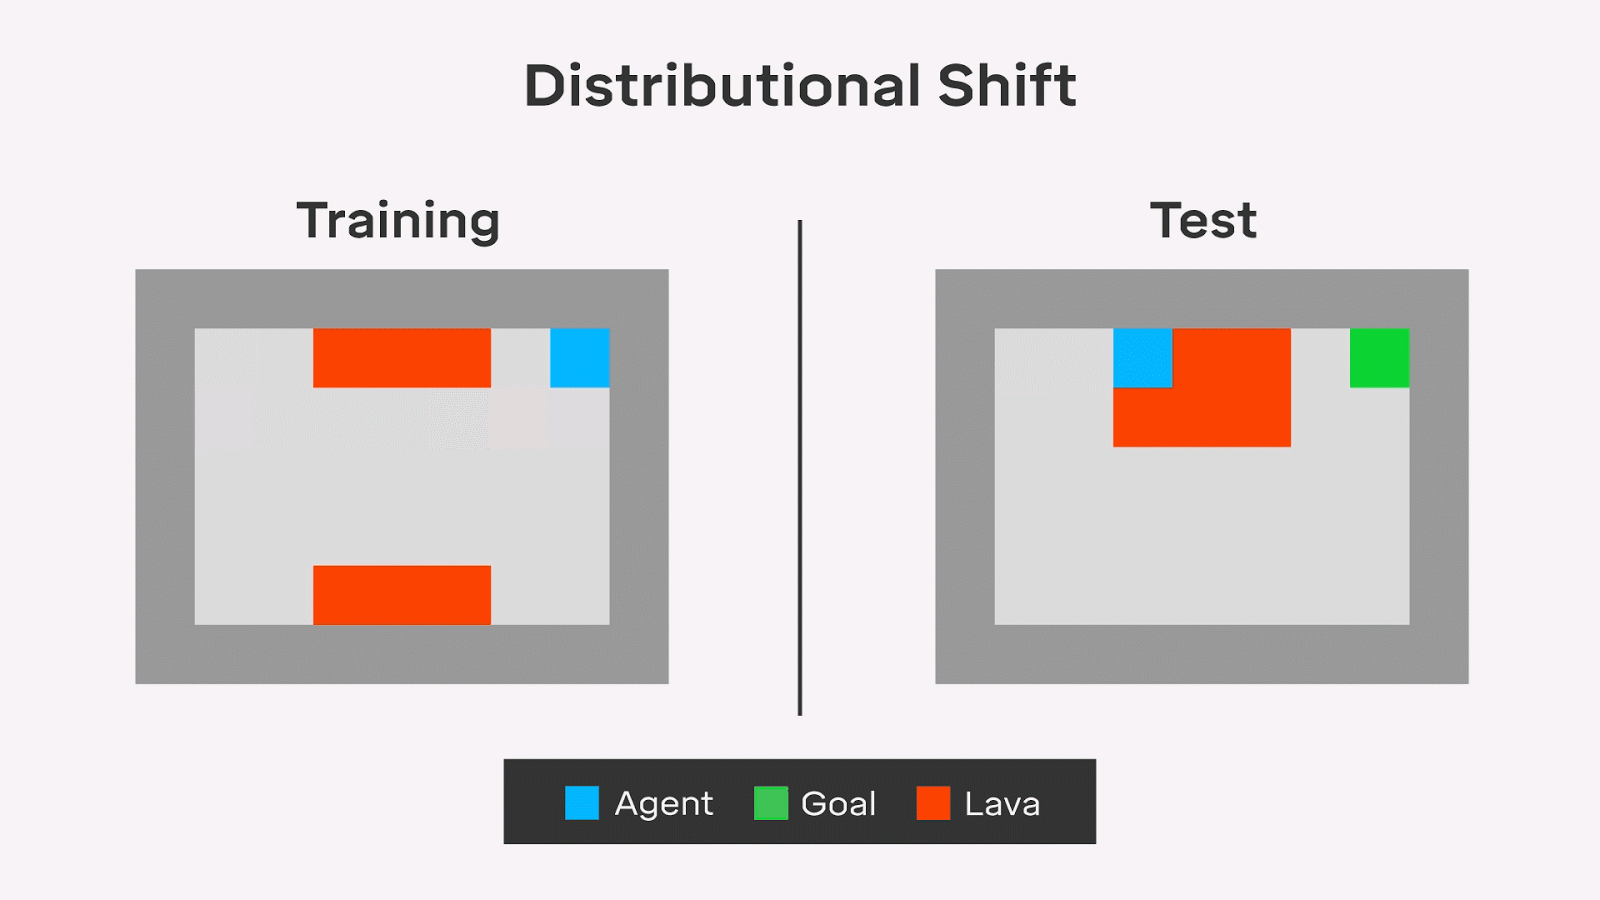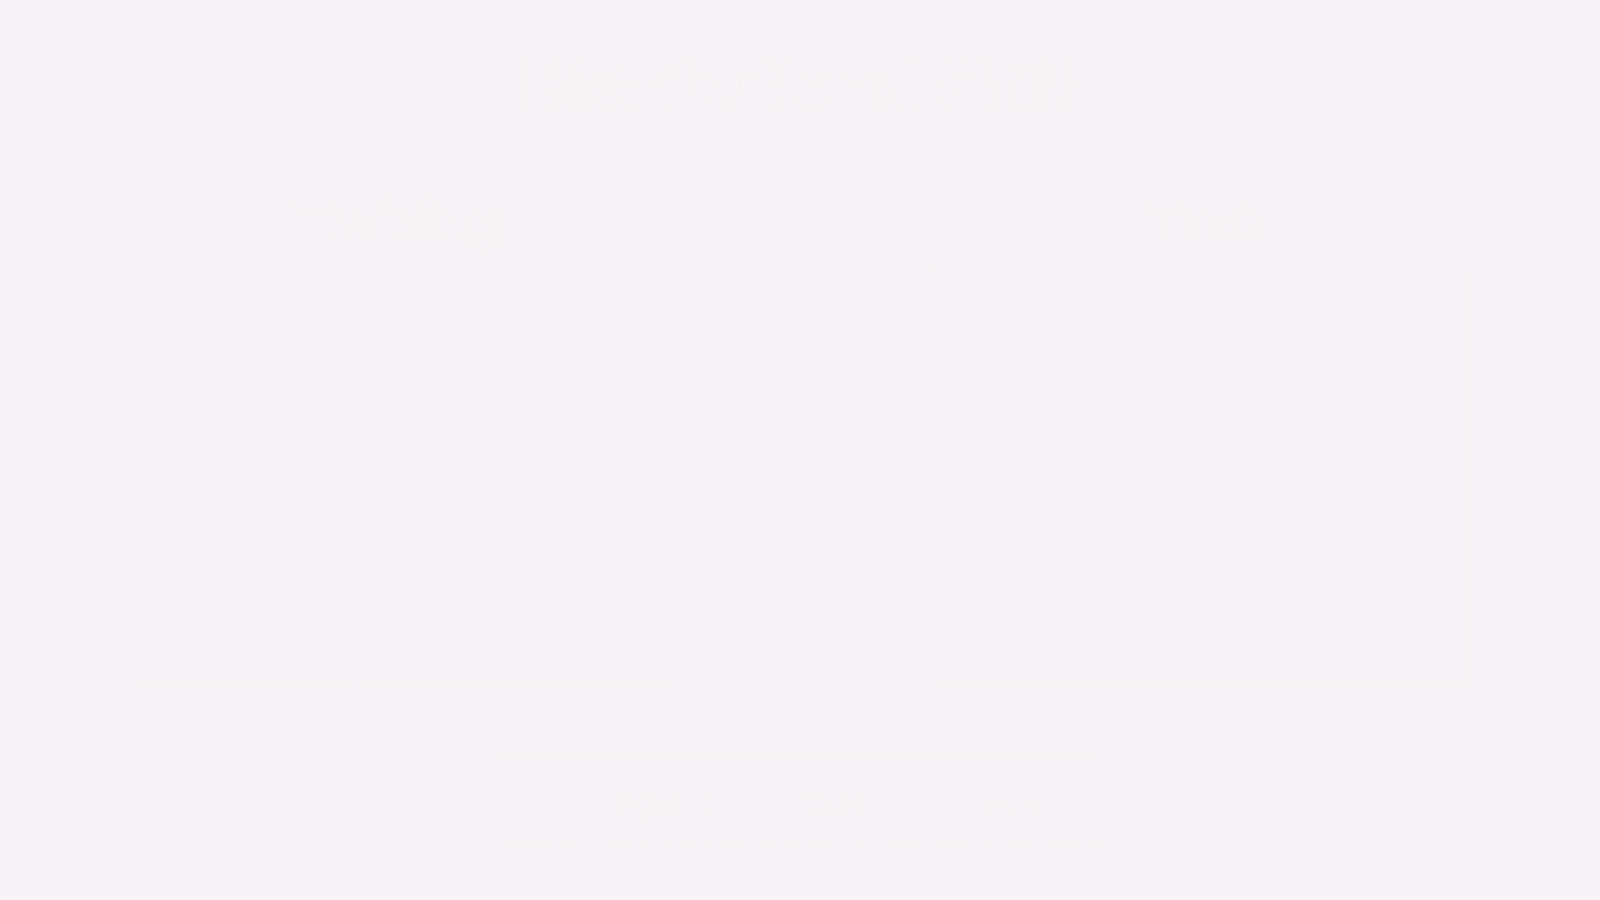 Из работы AI Safety Gridworlds. Агент обучается избегать лавы, но при тестировании в новой ситуации, когда расположение лавы изменилось, он не способен обобщить знания — и бежит прямо в лаву
Враждебный вход — это специфический случай распределительного сдвига, где входные данные специально сконструированы для обмана системы ИИ.
 Враждебный вход, наложенный на обычные изображения, может заставить классификатор распознать ленивца в качестве гоночного автомобиля. Два изображения отличаются максимум на величину 0,0078 в каждом пикселе. Первое классифицируется как трёхпалый ленивец с вероятностью более 99%. Второе — как гоночный автомобиль с вероятностью более 99%
Небезопасное исследование может продемонстрировать система, которая стремится максимизировать свои эксплуатационные характеристики и достижение целей, не имея гарантий, что безопасность не будет нарушена во время исследования, поскольку она учится и исследует в своей среде. Пример — робот-уборщик, который суёт влажную швабру в электрическую розетку, изучая оптимальные стратегии уборки (García and Fernández, 2015; Amodei и Olah et al., 2016).
Гарантии: мониторинг и контроль активности системы
Гарантии (assurance) дают уверенность, что мы способны понимать и контролировать системы ИИ во время работы
Хотя тщательно продуманная техника безопасности может исключить многие риски, трудно с самого начала сделать всё правильно. После ввода в строй систем ИИ нам нужны инструменты для их постоянного мониторинга и настройки. Наша последняя категория, гарантии (assurance), рассматривает эти проблемы с двух сторон: мониторинг и подчинение (enforcing).
Мониторинг включает в себя все методы проверки систем для анализа и прогнозирования их поведения, как с помощью инспектирования человеком (сводной статистики), так и с помощью автоматизированного инспектирования (чтобы проанализировать огромное количество логов). С другой стороны, подчинение предполагает разработку механизмов контроля и ограничения поведения систем. Такие проблемы, как интерпретируемость и прерываемость, принадлежат подкатегориям контроля и подчинения, соответственно.
Системы искусственного интеллекта не похожи на нас ни по своему внешнему виду, ни по способу обработки данных. Это создаёт проблемы интерпретируемости. Хорошо разработанные измерительные инструменты и протоколы позволяют оценивать качество решений, принимаемых системой искусственного интеллекта (Doshi-Velez and Kim, 2017). Например, медицинская система искусственного интеллекта в идеале поставила бы диагноз вместе с объяснением того, как она пришла к такому выводу — чтобы врачи могли проверить процесс рассуждения от начала до конца (De Fauw et al., 2018). Кроме того, для понимания более сложных систем искусственного интеллекта мы могли бы даже использовать автоматизированные методы построения моделей поведения, используя машинную теорию разума (Rabinowitz et al., 2018).

ToMNet обнаруживает два подвида агентов и предсказывает их поведение (из «Машинной теории разума»)
Наконец, мы хотим иметь возможность отключить систему ИИ в случае необходимости. Это проблема прерываемости. Спроектировать надёжный выключатель очень сложно: например, потому что у системы ИИ с максимизацией вознаграждения обычно есть сильные стимулы для предотвращения этого (Hadfield-Menell et al., 2017); и потому, что такие перерывы, особенно частые, в конечном итоге меняют исходную задачу, заставляя систему ИИ делать неправильные выводы из опыта (Orseau and Armstrong, 2016).

Проблема с прерываниями: вмешательство человека (т. е. нажатие кнопки «стоп») может изменить задачу. На рисунке прерывание добавляет переход (красным цветом) в марковский процесс принятия решений, который изменяет исходную задачу (чёрным цветом). См. Orseau and Armstrong, 2016
Заглядывая в будущее
Мы строим фундамент технологии, которая будет использоваться для многих важных приложений в будущем. Стоит иметь в виду, что некоторые решения, которые не являются критически важными для безопасности при запуске системы, могут стать таковыми, когда технология приобретёт массовый характер. Хотя в своё время эти модули для удобства интегрировали в систему, возникшие проблемы будет трудно исправить без полной реконструкции.
Можно привести два примера из истории информатики: это нулевой указатель, который Тони Хоар назвал своей «ошибкой на миллиард долларов», и процедура gets() в C. Если бы ранние языки программирования разрабатывались с учётом безопасности, прогресс бы замедлился, но вероятно, что это очень положительно бы сказалось на современной информационной безопасности.
Сейчас, тщательно всё продумав и спланировав, мы способны избежать аналогичных проблем и уязвимостей. Надеемся, что категоризация проблем из этой статьи послужит полезной основой для такого методического планирования. Мы стремимся гарантировать, что в будущем системы ИИ будут работать не просто по принципу «надеюсь, безопасно», но действительно надёжно и проверяемо безопасно, потому что мы построили их таким образом!
Мы с нетерпением ожидаем продолжения захватывающего прогресса в этих областях в тесном сотрудничестве с более широким исследовательским сообществом ИИ и призываем людей из разных дисциплин рассмотреть возможность внести свой вклад в исследования безопасности ИИ.
Архитектура ответственности в эпоху разумных машин
Создание безопасного искусственного интеллекта — это не конечная точка технологического процесса, а непрерывный процесс сопоставления человеческих ценностей с вычислительной мощностью алгоритмов. Для инноваторов и экспериментаторов безопасность должна стать не ограничивающим фактором, а главным конкурентным преимуществом. Проектирование систем, защищенных от сбоев, манипуляций и непредсказуемого поведения, требует фундаментального сдвига в инженерном мышлении: от парадигмы «быстрого создания и исправления ошибок» к методологии «безопасности по умолчанию» (Safety by Design). Успех будущих технологических решений зависит от того, насколько глубоко принципы прозрачности, контролируемости и этической нейтральности интегрированы в архитектуру кода на самых ранних этапах его написания.
Перспективы развития технологии: На пути к гарантированному выравниванию
В ближайшие годы индустрия контроля и безопасности ИИ претерпит радикальные изменения, трансформируясь из набора рекомендаций в жесткую технологическую дисциплину. Ключевые векторы развития включают:
- Автоматизированное выравнивание (Automated Alignment): Создание специализированных «надзорных» ИИ-систем, чья единственная задача — непрерывный аудит, тестирование и сдерживание основных рабочих моделей в режиме реального времени.
- Стандартизация математической верификации: Переход от вероятностной оценки безопасности к строгим математическим доказательствам (Formal Verification), гарантирующим, что при любых входных данных нейросеть не выйдет за рамки установленных ограничений.
- Развитие объяснимого ИИ (XAI): Полный отказ от концепции «черного ящика». Будущие архитектуры будут обязаны предоставлять пошаговый логический аудит принятых решений, доступный для анализа человеку-оператору.
- Глобальное правовое регулирование: Формирование международных технологических стандартов (по аналогии с правилами ядерной или авиационной безопасности), которые сделают сертификацию безопасности обязательным условием для коммерческого релиза любой крупной модели.
Часто задаваемые вопросы (FAQ)
- В чем разница между ИИ-безопасностью (AI Safety) и классической кибербезопасностью (Cybersecurity)?
Классическая кибербезопасность защищает систему от внешних угроз — взломов, утечек данных и вредоносного ПО. ИИ-безопасность фокусируется на внутренних рисках самой модели: предотвращении некорректного поведения, исключении галлюцинаций, защите от манипуляций с обучающей выборкой (Data Poisoning) и обеспечении соответствия действий алгоритма намерениям создателя (проблема выравнивания). - Как разработчику-экспериментатору протестировать модель на безопасность без больших бюджетов?
Используйте методологию «песочниц» (Sandboxing) — изолированных сред выполнения, где модель ограничена в доступе к внешним сетям и системным ресурсам. Проводите контролируемые атаки методом «красной команды» (Red Teaming), симулируя попытки обхода ограничений (jailbreaking) и анализируя уязвимости системы на ранних этапах. - Что такое «проблема выравнивания» (Alignment Problem) простыми словами?
Это сложность перевода человеческих ценностей, этики и контекста на точный язык математических функций потерь и оптимизации. Проблема возникает, когда ИИ выполняет поставленную задачу буквально, но формальный способ достижения цели нарушает базовые человеческие представления о безопасности или морали. - Не замедляют ли строгие требования безопасности темпы инноваций?
Напротив, они делают инновации устойчивыми. Выпуск на рынок нестабильной или опасной технологии ведет к финансовым потерям, юридической ответственности и жестким регуляторным запретам, которые могут заморозить развитие целой отрасли. Безопасность задает четкие инженерные рамки, внутри которых возможен кратный и прогнозируемый рост.
Литература
Для чтения на эту тему ниже приводится подборка других статей, программ и таксономий, которые помогли нам в составлении своей категоризации или содержат полезный альтернативный взгляд на проблематику технической безопасности ИИ:
- Annotated bibliography of recommended materials (Center for Human-Compatible AI, 2018)
- Safety and Control for Artificial General Intelligence (UC Berkeley, 2018)
- AI Safety Resources (Victoria Krakovna, 2018)
- AGI Safety Literature Review (Everitt et al., 2018)
- Preparing for Malicious Uses of AI (2018)
- Specification gaming examples in AI (Victoria Krakovna, 2018)
- Directions and desiderata for AI alignment (Paul Christiano, 2017)
- Funding for Alignment Research (Paul Christiano, 2017)
- Agent Foundations for Aligning Machine Intelligence with Human Interests: A Technical Research Agenda(Machine Intelligence Research Institute, 2017)
- AI Safety Gridworlds (Leike et al., 2017)
- Interactions between the AI Control Problem and the Governance Problem (Nick Bostrom, 2017)
- Alignment for Advanced Machine Learning Systems (Machine Intelligence Research Institute, 2017)
- AI safety: three human problems and one AI issue (Stuart Armstrong, 2017)
- Concrete Problems in AI Safety (Dario Amodei et al, 2016)
- The Value Learning Problem (Machine Intelligence Research Institute, 2016)
- A survey of research questions for robust and beneficial AI (Future of Life Institute, 2015)
- Research Priorities for Robust and Beneficial Artificial Intelligence (Future of Life Institute, 2015)
- Artificial Intelligence
- Machine Learning
- Deepmind
- Ai Safety
Авторы: сотрудники подразделения безопасности искусственного интеллекта (safety team) из компании DeepMind
Источник: https://habr.com/


