
 Автоматизированная генерация разнообразных визуальных образов на основе анализа текстовых описаний, составленных на естественном языке, представляет собой актуальную задачу, востребованную во многих сферах человеческой деятельности. Спектр применения данных технологий включает создание художественных произведений искусства, а также разработку дизайна интерьеров и продукции различного функционального назначения. Решение данной задачи стимулирует прогресс в области мультимодального обучения искусственного интеллекта, обеспечивающего взаимосвязь между визуальным восприятием и языковыми структурами. Современные исследования в этой области преимущественно базируются на использовании генеративно-состязательных сетей (GAN). Основным методом реализации является преобразование полного текстового описания в глобальное векторное пространство предложений..
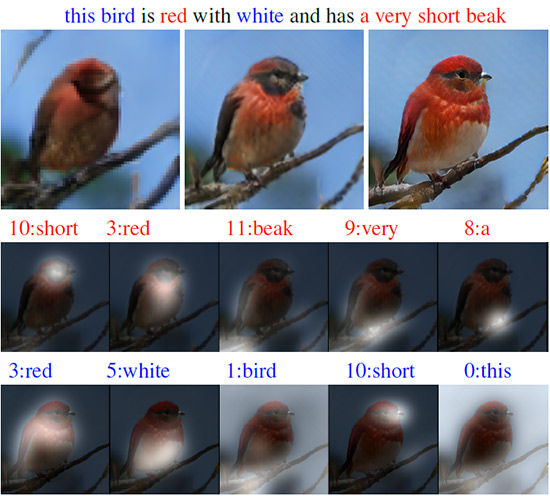
Пример работы AttnGAN. В верхнем ряду несколько изображений разного разрешения, сгенерированные нейросетью. Во втором и третьем рядах показана обработка пяти наиболее подходящих слов двумя моделями внимания нейросети для отрисовки наиболее релевантных участков
Такой подход демонстрирует ряд впечатляющих результатов, но у него есть главные недостатки: отсутствие чёткой детализации на уровне слов и невозможность генерации изображений высокого разрешения.
Группа разработчиков из Лихайского университета, Ратгерского университета, Университета Дьюка (все — США) и компании Microsoft предложили своё решение проблемы: новая нейросеть Attentional Generative Adversarial Network (AttnGAN) представляет собой улучшение традиционного подхода и позволяет многоступенчато изменять сгенерированное изображение, меняя отдельные слова в текстовом описании.

Как видно на иллюстрации с изображением архитектуры нейросети, в модели AttnGAN есть две инновации по сравнению с традиционными подходами. Во-первых, это генеративно-состязательная сеть, которая относится к вниманию как к фактору обучения (Attentional Generative Adversarial Network). То есть в ней реализован механизм внимания, который определяет слова, наиболее подходящие для генерации соответствующих частей картинки. Другими словами, кроме кодирования всего текстового описания в глобальном векторном пространстве предложений, каждое отдельное слово тоже кодируется в виде текстового вектора.
На первом этапе генеративная нейросеть использует глобальное векторное пространство предложений для отрисовки изображения низкого разрешения. На следующих этапах она использует вектор изображения в каждом регионе для запроса словарных векторов, используя слой внимания для формирования словоконтекстного вектора. Затем региональный вектор изображения комбинируется с соответствующим словоконтекстным вектором для формирования мультимодального контекстного вектора, на основании которого модель генерирует новые признаки изображения в соответствующих регионах. Это позволяет эффективно повысить разрешение всего изображения в целом, поскольку на каждом этапе появляется всё бóльшая детализация.
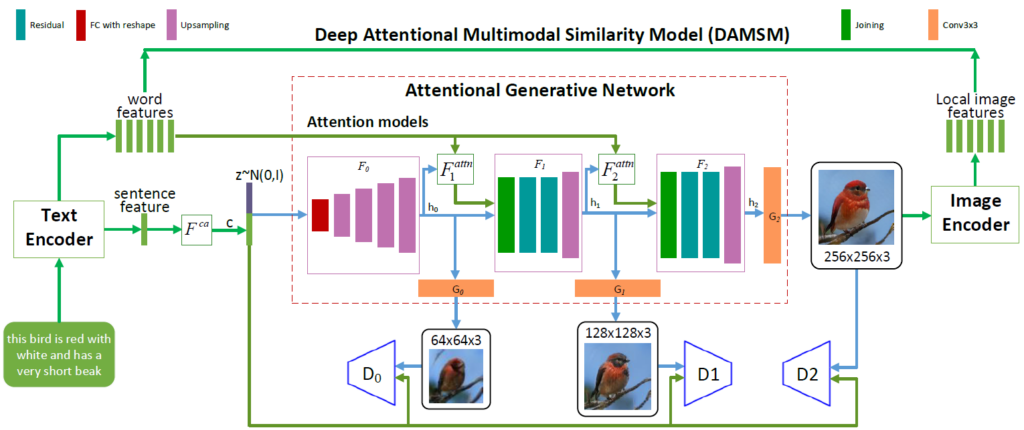
Архитектура нейросети AttnGAN. Каждая модель внимания автоматически получает условия (то есть соответствующие словарные векторы) для генерации разных областей изображения. Модуль DAMSM обеспечивает дополнительную детализацию для функции потерь соответствия на переводе из изображения в текст в генеративной сети
Вторая инновация нейросети от Microsoft — это модуль Deep Attentional Multimodal Similarity Model (DAMSM). Используя механизм внимания, этот модуль вычисляет степень похожести сгенерированного изображения и текстового предложения, используя одновременно и информацию с уровня векторного пространства предложений, и с хорошо детализированного уровня словарных векторов. Таким образом, DAMSM обеспечивает дополнительную детализацию для функции потерь соответствия на переводе из изображения в текст при обучении генератора.
Благодаря этим двум инновациям нейросеть AttnGAN показывает значительно лучшие результаты, чем самые лучшие из традиционных систем GAN, пишут разработчики. В частности, максимальный из известных показателей inception score для существующих нейросетей улучшен на 14,14% (с 3,82 до 4,36) на наборе данных CUB и улучшен на целых 170,25% (с 9,58 до 25,89) на более сложном наборе данных COCO.
Важность этой разработки трудно переоценить. Нейросеть AttnGAN впервые показала, что многослойная генеративно-состязательная сеть, которая относится к вниманию как к фактору обучения, способна автоматически определять условия на уровне слов для генерации отдельных частей изображения. Научная статья опубликована на сайте препринтов arXiv.org (arXiv:1711.10485v1).
Для любознательных
В России и в мире есть несколько ключевых компаний и исследовательских групп, которые активно разрабатывают и применяют нейросети, использующие векторное пространство слов и предложений для генерации изображений — то есть модели, способные понимать текст и превращать его в картинки. Это направление называется text-to-image generation (генерация изображений по тексту), и оно строится как раз на преобразовании текста в векторные представления (эмбеддинги), которые затем интерпретируются нейросетью для создания визуального контента.
В России:
- «Яндекс» — «Шедеврум»
- Это одна из самых заметных российских разработок в области генерации изображений по тексту.
- Использует каскадную диффузную модель, обученную на 500 млн пар «текст-изображение» на русском и английском языках.
- Преобразует текстовый запрос в векторное пространство, а затем генерирует картинку в нужном стиле (например, «в стиле Ван Гога» или «мультфильм»).
- Интерфейс полностью на русском, что делает её особенно удобной для русскоязычных пользователей.
- Доступна через сайт, Telegram-бота и приложение.
- Сбер — Kandinsky 2.1
- Первая отечественная open-source нейросеть для генерации изображений по тексту.
- Также использует текстовые эмбеддинги (векторы предложений) для управления генерацией.
- Может работать как через веб-интерфейс, так и интегрироваться в другие сервисы.
- Поддерживает сложные описания и умеет имитировать художественные стили.
- Разработана совместно с МФТИ и Сколтехом.
- Университет Иннополис — НейроХудожник
- Проект студентов, представленный на KazanForum.
- Использует BLIP-large для анализа набросков и текста, а Stable Diffusion v1.5 — для генерации.
- Позволяет превращать простые рисунки в картины в стилях Шишкина, Малевича, Миядзаки или Бэнкси.
- Хорошо справляется с сохранением структуры исходного наброска.
В мире:
- OpenAI — DALL·E 2 и DALL·E 3
- Одни из самых продвинутых моделей в мире.
- Используют CLIP (Contrastive Language–Image Pretraining) — модель, которая обучается на парах «текст-изображение» и строит общее векторное пространство для слов и картинок.
- DALL·E 3 интегрирован в ChatGPT и умеет генерировать очень точные и детализированные изображения по сложным запросам.
- Stability AI — Stable Diffusion
- Открытая модель, ставшая основой для множества других (включая Kandinsky).
- Использует текстовые эмбеддинги из модели CLIP или T5 для управления генерацией.
- Работает локально и онлайн, что делает её очень гибкой.
- Поддерживает тысячи стилей, плагинов и кастомных версий.
- Midjourney
- Очень популярна среди художников и дизайнеров.
- Работает через Discord, но даёт исключительно качественные и художественные результаты.
- Использует внутреннюю архитектуру, похожую на диффузионные модели с текстовым контролем.
- Отлично понимает абстрактные и поэтические описания.
- Google — Imagen и Parti
- Imagen использует T5-XXL для преобразования текста в векторы и показывает отличное понимание языка.
- Пока не выпущена публично, но демонстрирует высокое качество.
- Parti — альтернативная модель, использующая архитектуру, похожую на трансформеры.
- NVIDIA — GauGAN
- Позволяет превращать сегментационные карты (простые наброски) в фотореалистичные пейзажи.
- Использует GAN-архитектуру и векторное представление сцен.
- Особенно хороша для ландшафтного дизайна и архитектуры.
Как это работает (простыми словами):
- Текст (например, «кот в космосе в скафандре») разбивается на слова и преобразуется в вектор — числовой код, который несёт смысл.
- Этот вектор подаётся в генеративную модель (например, диффузионную), которая «рисует» изображение, постепенно улучшая его, ориентируясь на смысл текста.
- Чем точнее векторное представление, тем лучше картинка соответствует запросу.
На Настоящее время:
Российские модели, такие как «Шедеврум» и Kandinsky, уже находятся на уровне мировых аналогов по качеству и удобству, особенно в части поддержки русского языка. Они активно развиваются и используются как в творчестве, так и в бизнесе — от рекламы до дизайна упаковок.


